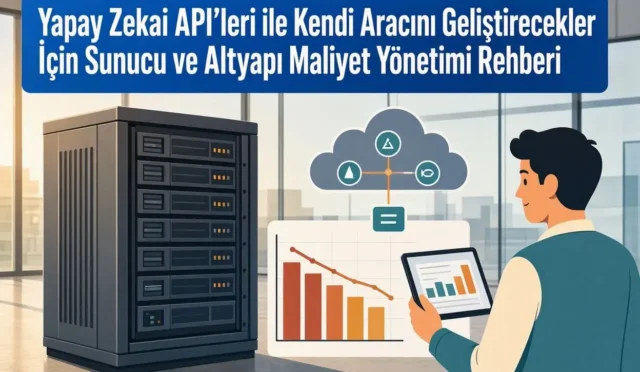

Yapay zeka modellerini bir web arayüzünde chat yapmak için kullanan son kullanıcılar, arka planda dönen mühendislik savaşlarından tamamen habersizdir. Ancak bir yapay zeka uygulaması entegre eden geliştiriciler, SaaS girişimcileri ve CTO’lar için durum tamamen farklıdır. Birkaç yıl öncesine kadar cloud mimarilerinde sanal sunucuların (VM) deterministic, yani saatlik veya aylık sabit maliyetlerini optimize etmeye alışmıştık. Geliştirici ekibimiz sunucuyu etiketler, kotasını belirler ve ay sonu ne geleceğini kuruşu kuruşuna bilirdi. Fakat yapay zekanın prodüksiyona (canlı ortama) girmesiyle birlikte, bulut bilişimin bu öngörülebilir doğası yerini tamamen non-deterministic (öngörülemez) ve hamleye göre değişen bir maliyet krizine bıraktı.
Özellikle OpenAI’ın o1 ve o3-mini modelleri ile açık kaynak dünyasında trilyon parametreli yapıyla dengeleri değiştiren DeepSeek-R1 gibi akıl yürüten (reasoning) büyük dil modelleri, token ekonomisini bambaşka bir boyuta taşıdı. Bu yeni nesil modellerle birlikte, modern yazılım mimarisinin en kritik disiplinlerinden biri doğmuş oldu: AI FinOps.
Reasoning Nedir ve Token Tüketimi Neden Lineer Büyümez?
Klasik LLM modelleri (GPT-4o mini, Claude 3.5 Haiku veya Llama 3 70B), bir prompt aldıklarında istatistiksel olarak bir sonraki en mantıklı kelime parçacığını (token) tahmin ederek doğrudan ekrana basarlar. Girdi uzunluğunuz ve çıktı sınırınız bellidir. Ancak akıl yürüten modellerde süreç lineer işlemez. Bu modeller, nihai cevabı üretmeden önce arka planda bir Chain of Thought (Düşünce Zinciri) mekanizması tetiklerler. Sizin gönderdiğiniz bir yazılım problemine yanıt vermeden önce, kendi içlerinde düzinelerce alternatif çözüm algoritması dener, hata yakalar, kendi mantığını çürütür ve yeniden inşa ederler.
İşte bu iç monolog esnasında harcanan ve kullanıcının ekranında asla görünmeyen kelime öbeklerine Reasoning Tokens (Düşünme Token’ları) denir. İşin mali kriz yaratan kısmı ise şudur: OpenAI ve DeepSeek dahil tüm büyük sağlayıcılar, yapay zekanın arka planda kendi kendine düşünürken ürettiği bu gizli token’ları geliştiricilere çıktı (output) tarifesi üzerinden faturalandırır. Bilindiği üzere yapay zeka API’lerinde çıktı token fiyatları, girdi token fiyatlarına göre 5 ila 6 kat daha pahalıdır.
Sonuç olarak, kullanıcınızın sitenize girdiği 50 kelimelik basit görünen bir optimizasyon isteği, yapay zekanın arka planda dakikalarca düşünmesi sebebiyle bir anda 8.000 çıktı token’lık devasa bir fatura yüküne dönüşebilir. Eğer uygulamanız binlerce eşzamanlı istek (concurrency) alıyorsa, tek bir gecede binlerce dolarlık plansız harcamalarla karşılaşmanız işten bile değildir.
AI Gateways ve proxy Katmanlarının Zorunluluğu
Canlıdaki bir uygulamanın doğrudan OpenAI veya DeepSeek API’lerine çıplak istek (raw request) atması, modern mimaride kabul edilemez bir güvenlik ve maliyet açığıdır. Uygulamanız ile yapay zeka sağlayıcıları arasına mutlaka bir AI Gateway ya da proxy katmanı konumlandırmak zorundasınız. Bunun temel sebebi, harcamaları tek bir fatura satırında görmek yerine, istek istek metrik analizi yapabilmektir.
Merkezi bir gateway mimarisi kullanmadığınızda, ay sonunda gelen tek bir fatura üzerinden hangi kullanıcının, hangi özelliğin ya da hangi sub-agent (alt ajan) döngüsünün bütçeyi tükettiğini ayırt edemezsiniz. Kuracağınız proxy katmanı her isteğe benzersiz bir Request ID atamalı; istek başında harcanan girdi, çıktı ve gizli düşünme token sayılarını anlık olarak veri tabanınıza loglamalıdır. Ancak bu sayede anomalileri anında tespit edebilir ve runaway agent (döngüye girip sonsuza kadar düşünen ajan) krizlerine müdahale edebilirsiniz.
Maliyet Yönetimi İçin Üç Aşamalı Operasyon Döngüsü
Uygulamanızın finansal sürdürülebilirliğini sağlamak için AI FinOps süreçlerini üç temel fazda ele almamız gerekir:
- Bilgilendirme (Inform): İlk aşama tam görünürlüktür. Sitenizdeki hangi interaktif aracın ne kadar token tükettiğini kullanıcı bazlı ölçmelisiniz. Birim ekonomi (unit economics) hesabı yaparak, kullanıcı başına elde ettiğiniz SaaS abonelik gelirinin yapay zeka maliyetini karşılayıp karşılamadığını netleştirmelisiniz.
- Optimizasyon (Optimize): Bu aşamada gereksiz harcamaları budamaya başlarız. Prompt sıkıştırma yöntemleri, anlamsal önbellekleme (semantic caching) ve modeller arası yönlendirme algoritmaları bu evrede devreye girer.
- Operasyon (Operate): Canlı sistemde gerçek zamanlı bütçe sınırları (rate-limiting ve circuit breakers) devreye alınır. Bir kullanıcı veya bir API anahtarı günlük belirlenen bütçe limitini aştığı anda sistem otomatik olarak isteği keser.
Kod Seviyesinde Model Yönlendirme (LLM Routing) Mimarisi
Her problemi en akıllı ve en pahalı modele çözdürmeye çalışmak, bütçe yönetimindeki en büyük hatadır. Geliştiriciler olarak backend tarafında akıllı yönlendiriciler (routers) tasarlamak zorundayız. Gelen promptun karmaşıklık seviyesini analiz edip, hafif işleri milisaniyeler içinde yanıt dönen ucuz modellere, ağır algoritmik problemleri ise akıl yürüten modellere paslamalıyız.
Aşağıdaki Python kod bloku, prodüksiyon ortamında kullanabileceğiniz, gelen kullanıcı isteğinin niteliğine göre maliyet odaklı çalışan dinamik bir LLM Router mimarisini göstermektedir:
import os
import openai

def advanced_llm_router(user_input: str) -> str:
    # Maliyet optimizasyonu için kritik anahtar kelime havuzu
    reasoning_keywords = ["optimize", "deadlock", "refactor", "cryptography", "mathematical proof", "algorithmic complexity"]

    # Gelen promptun analiz edilmesi
    is_complex = any(word in user_input.lower() for word in reasoning_keywords)

    try:
        if is_complex:
            # İstek ağır mantık gerektiriyorsa akıl yürüten modeli (o3-mini) çağırıyoruz
            response = openai.ChatCompletion.create(
                model="o3-mini",
                messages=[{"role": "user", "content": user_input}],
                reasoning_effort="medium" # Düşünme derinliğini orta seviyede sınırlıyoruz
            )
            return response.choices[0].message.content
        else:
            # İstek rutin bir metin veya basit kod işiyse ucuz modeli (gpt-4o-mini) çağırıyoruz
            response = openai.ChatCompletion.create(
                model="gpt-4o-mini",
                messages=[{"role": "user", "content": user_input}]
            )
            return response.choices[0].message.content

    except Exception as e:
        return f"Router Error: {str(e)}"
Yukarıdaki mimari sayesinde, basit bir metin düzenleme veya standart HTML tablosu oluşturma isteği için o3-mini gibi maliyetli bir modele çıktı ve düşünme token bedeli ödemezsiniz. Sistem sadece tetikleyici kelimeleri gördüğünde yüksek zeka katmanını devreye sokar.
Asenkron Sistemler İçin Node.js ile Akış Kontrolü ve Circuit Breaker
Eğer uygulamanız asenkron veya event-driven (olay güdümlü) bir yapıda çalışıyorsa, özellikle AI Ajanlarının (AI Agents) kendi aralarında yaptığı çoklu konuşmalarda token tüketiminin çığ gibi büyümesini engellemek adına Node.js tarafında katı sınırlandırıcılar (Circuit Breaker) uygulamalısınız. Ajanlar bazen sonsuz döngüye (infinite loop) girerek aynı problemi çözmek için arka arkaya binlerce akıl yürütme isteği atabilirler.
Aşağıdaki Node.js kod yapısı, tek bir kullanıcı oturumunda veya görevinde belirlenen maksimum token sınırı aşıldığı anda API çağrılarını otomatik olarak kesen bir koruma kalkanı simülasyonudur:
const { OpenAI } = require("openai");
const openai = new OpenAI();

class TokenCircuitBreaker {
    constructor(maxTokenBudget) {
        this.maxTokenBudget = maxTokenBudget;
        this.consumedTokens = 0;
    }

    async executeReasoningTask(prompt) {
        // Devre kesici kontrolü
        if (this.consumedTokens >= this.maxTokenBudget) {
            throw new Error("AI FinOps Koruması: Kullanıcı token harcama limiti aşıldı. İstek engellendi.");
        }

        const response = await openai.chat.completions.create({
            model: "o3-mini",
            messages: [{ role: "user", content: prompt }],
            max_completion_tokens: 2000 // Kod seviyesinde kesin üst sınır koyuyoruz
        });

        // Sağlayıcıdan gelen gerçek tüketim verilerini logluyoruz
        const totalUsed = response.usage.total_tokens;
        this.consumedTokens += totalUsed;

        console.log(`Görev Başarılı. Harcanan Token: ${totalUsed}. Toplam Akümüle Tüketim: ${this.consumedTokens}`);
        return response.choices[0].message.content;
    }
}
Bu Node.js mimarisi, özellikle arka planda kuyruk yönetimi (Queue Management) yapan SaaS uygulamalarında cüzdan güvenliğini garanti altına alır. `max_completion_tokens` parametresi, modelin ne kadar harika düşünebilirse düşünsün, belirlediğiniz sınırın ötesine geçerek faturayı şişirmesine yasal bir barikat koyar.
Düşünme Bütçesini Dizginleme Parametreleri
Sağlayıcılar API güncellemeleriyle geliştiricilere modellerin düşünme sürelerine müdahale etme yetkisi tanımıştır. OpenAI entegrasyonlarında `reasoning_effort` parametresini `low` olarak set ettiğinizde, model problemi çözmek için derinlemesine felsefi analizler yapmak yerine en kararlı ve hızlı mantık zincirini seçer. Bu da hem API yanıt süresini (latency) düşürür hem de gizli düşünme token’larının faturadaki payını ciddi oranda azaltır.
DeepSeek-R1 tarafında ise eğer kendi sunucunuzda (open-source vLLM altyapısıyla) barındırma yapmıyorsanız ve doğrudan API kullanıyorsanız, gelen yanıtlardaki `
` bloklarının uzunluğunu backend tarafında parser mimarileriyle takip etmeli ve anormallik sezdiğiniz anlarda akışı kapatacak timeout mekanizmaları kurmalısınız.
Sonuç ve Geleceğin Yapay Zeka Mimarisi
Yapay zeka tabanlı yazılım geliştirme dünyası artık sadece en yaratıcı promptları yazma becerisinden ibaret değildir. Sektör geliştikçe, kod yazma becerisi kadar sistem kaynaklarını ve bütçeyi optimize etme kabiliyeti de ön plana çıkmaktadır. 2026 yılı ve sonrası, tamamen unit economics ve AI FinOps prensiplerine sadık kalan girişimlerin ayakta kalacağı bir dönem olacaktır.
Akıl yürüten modeller yazılımcılara sınırsız bir kabiliyet alanı sundu; fakat bu gücü başıboş bırakmak operasyonel felaketleri beraberinde getirebilir. Uygulamanızın backend mimarisine akıllı yönlendiriciler yerleştirerek, modellerin düşünme bütçelerini kod seviyesinde dizginleyerek ve her isteği anlık olarak izleyerek hem kullanıcılarınıza üst düzey yapay zeka deneyimi sunabilir hem de bütçenizi kusursuz bir şekilde koruyabilirsiniz.