
Mobil uygulama dünyasında büyük bir paradigma değişiminin tam ortasındayız. Bugüne kadar yapay zeka denildiğinde aklımıza hep şu senaryo geliyordu: Kullanıcı bir istek yapar, bu istek bir API aracılığıyla uzak sunuculara (buluta) gönderilir, orada devasa modeller tarafından işlenir ve saniyeler sonra telefona geri döner.
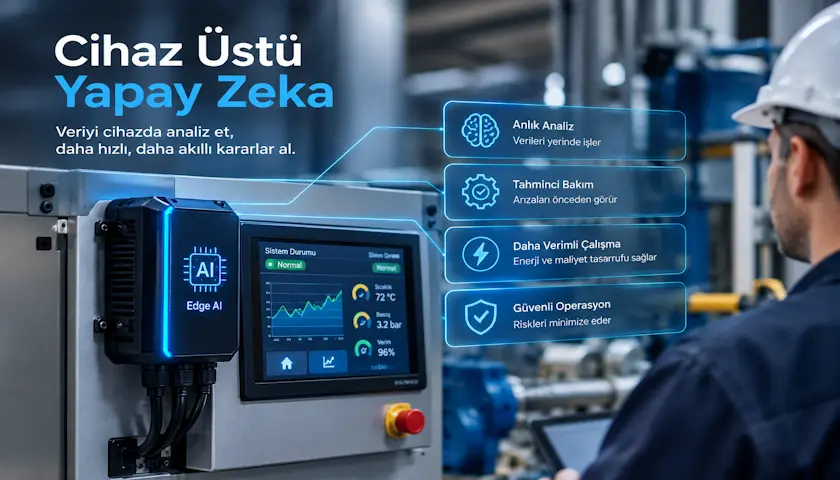
Ancak bu senaryo artık eskimeye başladı. Milyarlarca parametrelik modellerin küçülmesi ve akıllı telefonların donanımsal olarak güçlenmesiyle birlikte artık yapay zekayı doğrudan kullanıcının cebinde, yani cihaz üstünde (on-device) çalıştırıyoruz. Bulut API’lerine veda etmeye hazırsanız, mobil cihazlarda yerel yapay zeka ajanları kurmanın mantığını ve Gemini Nano ile Llama 3.2 entegrasyonlarının nasıl yapıldığını derinlemesine inceleyelim.
Neden Bulut API’lerini Bırakıyoruz? (Acı Gerçekler)
Geliştiriciler olarak OpenAI, Anthropic veya Google Cloud API’lerini uygulamalarımıza entegre etmek ilk başta çok kolay geliyordu. Fakat ölçeklenmeye başladığınızda şu üç büyük duvarla karşılaşırsınız:
- Öngörülemeyen Sunucu Maliyetleri: Kullanıcı sayınız arttıkça aylık API faturalarınız katlanarak büyür. Şirketler için yapay zeka maliyet yönetimi ve kaynak planlaması bu aşamada kritik bir hal alır. Cihaz üstü yapay zekada ise işlem gücü kullanıcının kendi telefonundan karşılandığı için sunucu maliyetiniz tam olarak 0 TL’dir.
- Gizlilik ve Güvenlik Duvarı: Kullanıcının mesajlarını, fotoğraflarını veya kişisel verilerini bir sunucuya göndermek artık hem regülasyonlar (KVKK, GDPR) açısından baş ağrısı hem de kullanıcı güvenini sarsan bir durum. Yerel modellerde veri cihazdan asla çıkmaz.
- Gecikme (Latency) ve İnternet Bağımlılığı: İnternetin çekmediği bir metroda veya uçakta bulut tabanlı yapay zeka çalışmaz. Ayrıca ağ gecikmesi, kullanıcı deneyimini hantallaştırır. Cihaz üstü modeller ise milisaniyeler içinde yanıt verir ve tamamen çevrimdışı (offline) çalışabilir.
1. Google Gemini Nano Entegrasyonu (Android Dünyası)
Google, Android ekosisteminde cihaz üstü yapay zekayı standartlaştırmak için AICore adında bir sistem servisi geliştirdi. Gemini Nano, bu servis aracılığıyla doğrudan telefonun NPU (Nöral İşlem Birimi) donanymını kullanarak çalışıyor. Bu sayede model uygulamanızın boyutunu büyütmüyor, sistemin kendi içinde hazır bekliyor.
Adım Adım Entegrasyon Mantığı:
Android projenizde Gemini Nano’yu kullanmak için Google’ın Google AI Edge SDK‘sını projenize dahil etmeniz gerekir.
// build.gradle (Module) içerisine ekleyin
dependencies {
    implementation "com.google.ai.edge.aicore:aicore-google-ai:1.0.0" // Güncel SDK sürümü
}
Kod Bloğu (Kotlin):
Modeli başlatmak ve bir metin üretmesini sağlamak oldukça basittir:
import com.google.ai.edge.aicore.GenerativeModel

// Gemini Nano modelini hazırlama
val generativeModel = GenerativeModel(
    modelName = "gemini-nano",
    apiKey = "GEREKLİ DEĞİL - AICore üzerinden yerel çalışır"
)

suspend fun yerelYapayZekaCevapUret(kullaniciSorusu: String): String {
    return try {
        // İstek doğrudan cihaz içinde işlenir
        val response = generativeModel.generateContent(kullaniciSorusu)
        response.text ?: "Bir hata oluştu."
    } catch (e: Exception) {
        "Model çalıştırılamadı: ${e.localizedMessage}"
    }
}
Not: Gemini Nano şu an için ağırlıklı olarak üst segment Pixel ve Samsung cihazlarda aktiftir, ancak Google AICore desteğini hızla diğer Android cihazlara da yaymaktadır.
2. Meta Llama 3.2 Entegrasyonu (Hem iOS Hem Android)
Meta’nın açık kaynaklı Llama 3.2 1B (1 milyar parametre) ve 3B (3 milyar parametre) modelleri, mobil cihazlar için biçilmiş kaftandır. En büyük avantajı ise cross-platform olmasıdır; yani aynı modeli hem iOS hem de Android uygulamanızda çalıştırabilirsiniz.
Meta, bu modelleri mobil cihazlarda donanım ivmeli (hardware-accelerated) çalıştırmak için ExecuTorch adı verilen bir çalışma zamanı (runtime) mimarisi sunuyor. Ancak projelerinizde doğru yapay zeka uygulaması seçimi yapmak ve mobil cihazın RAM/işlemci limitlerine uygun mimariyi kurmak, kullanıcı deneyimini doğrudan etkileyen en önemli unsurdur.
Adım Adım Entegrasyon Mantığı:
- Modeli Optimize Etme (Quantization): Llama 3.2 modelini doğrudan telefona atamazsınız (boyutu çok büyük olur). İlk olarak modeli
4-bitveya8-bitboyutlarına düşürerek (Quantization işlemi).pteuzantılı bir ExecuTorch formatına dönüştürmeniz gerekir. - Kütüphane Kurulumu: iOS için Swift Package Manager (SPM) veya CocoaPods, Android için ise CMake/C++ katmanını kullanan ExecuTorch kütüphanelerini projenize eklersiniz.
iOS İçin Swift Örneği:
import Executorch

class LlamaManager {
    private var runner: Predictor?

    init() {
        // Önceden indirilmiş ve optimize edilmiş llama3_2.pte model dosyasının yolu
        if let modelPath = Bundle.main.path(forResource: "llama3_2", ofType: "pte") {
            self.runner = Predictor(modelPath: modelPath)
        }
    }

    func soruSor(prompt: String) -> String {
        guard let model = runner else { return "Model yüklenemedi." }

        // Cihaz içi NPU/GPU kullanarak çıkarım yapılır
        let sonuc = model.predict(prompt: prompt)
        return sonuc
    }
}
Geleceğin Trendi: “Yapay Zeka Ajanları” Kurmak
Sadece soru-cevap yapan bir model kurmak artık yetmiyor. Hedefimiz Cihaz Üstü Yapay Zeka Ajanları (On-Device AI Agents) oluşturmak. Bir ajanın normal bir dil modelinden farkı, telefonun lokal fonksiyonlarına erişebilmesidir. Küçük yerel modellerde yüksek performans almak ve bağlamı daraltmak için ileri düzey prompt mühendisliği tekniklerinden yararlanmak hayati önem taşır.
Örnek Senaryo: Kullanıcı uygulamaya “Yarın sabah beni erkenden uyandır ve bugünkü toplantı notlarımı özetle” dediğinde, cihaz üstündeki Gemini Nano veya Llama 3.2:
- İnternete gitmeden kullanıcının cihazındaki notlar uygulamasından veriyi okur.
- Metni kendi içinde saniyeler içinde özetler.
- Function Calling (Fonksiyon Çağırma) yeteneği sayesinde telefonun yerel alarm kurma kodunu tetikler.
Tüm bu süreç boyunca kullanıcının hiçbir verisi dışarı sızmaz ve tek bir kuruş sunucu maliyeti oluşmaz.
Son Söz ve Geliştiriciye Öneriler
Bulut API’lerini tamamen hayatımızdan çıkarmak şu an için radikal bir karar olabilir. Özellikle sıfır sunucu maliyetiyle SaaS proje mimarisi tasarlamak ve mobil odaklı girişimler kurmak isteyen indie geliştiriciler için cihaz üstü modeller bulunmaz bir nimettir. En mantıklı yaklaşım, Hibrit Mimari (Hybrid AI) kullanmaktır.
Basit metin özetleme, form doldurma, cihaz içi arama ve temel sohbet gibi işlemleri Gemini Nano veya Llama 3.2 ile cihaz üstünde çözün. Çok daha karmaşık, devasa veri analizi gerektiren işleri ise buluttaki modellere (Gemini Pro, GPT-4o) devredin. Bu sayede hem kullanıcı deneyimini uçurur hem de şirket bütçesini korumuş olursunuz.