
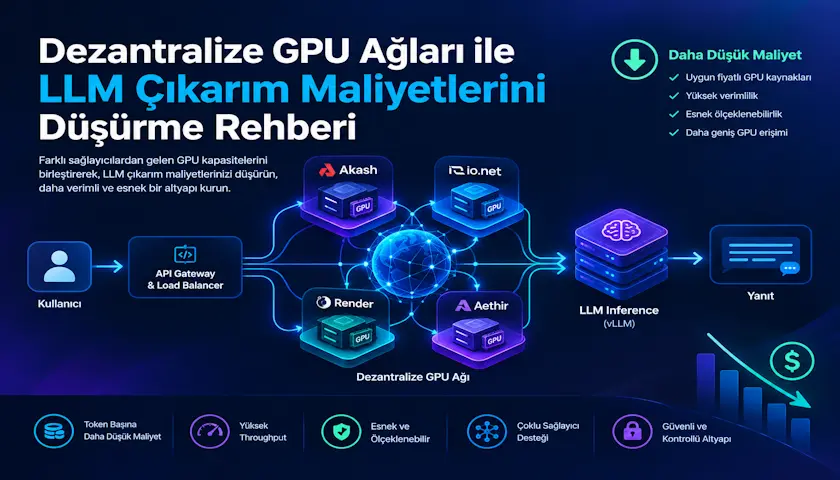
Merkezi yapay zeka sağlayıcılarının (OpenAI, Anthropic veya Google Gemini gibi) token tabanlı fiyatlandırma modelleri, ölçeklenen SaaS projeleri için bir süre sonra en büyük finansal kara deliğe dönüşüyor. Özellikle akıl yürüten (reasoning) modellerin ve çoklu ajan (multi-agent) sistemlerinin devreye girmesiyle birlikte, döngüsel girdi ve çıktı token mimarileri bütçeleri ciddi şekilde zorlamaya başladı. Geliştiriciler için tek çözüm, açık kaynaklı kod bloklarını (DeepSeek-R1 veya Llama 3 sürümleri gibi) kendi altyapılarında barındırmaktır. Ancak geleneksel AWS, Google Cloud veya Azure üzerinden GPU (örneğin Nvidia A100, H100 veya A10G) kiralamak hem yüksek taahhütler gerektirir hem de saatlik maliyetleri mikro girişimler (Micro-SaaS) için sürdürülebilir değildir.
Bu derinlemesine rehberde, merkezi bulut sağlayıcıları yerine Akash Network veya Nosana gibi dezantralize (merkeziyetsiz) GPU ağları üzerinde kendi açık kaynaklı modelimizi vLLM kütüphanesi kullanarak nasıl ayağa kaldıracağımızı, altyapı maliyetlerimizi nasıl radikal bir şekilde düşüreceğimizi ve projemize güvenli bir API köprüsüyle nasıl bağlayacağımızı pratik kod seviyesinde inceliyoruz.
1. Dezantralize GPU Altyapısı Nedir ve Neden Ucuzdur?
Dezantralize bilgi işlem ağları, dünya genelindeki veri merkezlerinde, bağımsız madencilik tesislerinde veya atıl durumdaki profesyonel stüdyolarda bulunan GPU gücünü blokzincir altyapısı ve akıllı sözleşmeler aracılığıyla tek bir havuzda birleştirir. Merkezi sağlayıcılar gibi devasa veri merkezi bakım operasyonları, kurumsal kar marjları ve pazarlama bütçeleri barındırmadıkları için ham bilgi işlem gücünü doğrudan pazar yeri mantığıyla (bidding/ihale usulü) sunarlar. Bu durum, aynı donanımı (örneğin bir Nvidia A10G veya RTX 4090) merkezi bulut sağlayıcılara kıyasla %60 ila %80 arasında daha ucuza kiralamanıza olanak tanır.
Ayrıca token başına (per-token) ödeme yapmak yerine, GPU’yu zaman bazlı (saatlik/aylık) kiraladığınız için SaaS uygulamanıza gelen binlerce istekte faturalarınız sürpriz bir şekilde katlanmaz. Sisteminiz sabit bir maliyet yapısına kavuşur.
2. SDL (Stack Definition Language) ile Konteyner Konfigürasyonu
Dezantralize bilgi işlem ağlarında sunucu mimarisini başlatmak ve orchestrate etmek için Docker konteyner yapısı kullanılır. Biz bu rehberde, yüksek performanslı ve OpenAI uyumlu API sunan vLLM motorunu kullanarak DeepSeek-R1-Distill-Qwen-14B modelini yayına alacağız. Ağa hangi kaynaklara ihtiyacımız olduğunu bildirmek için yazacağımız deploy.sdl dosyasının eksiksiz mimarisi şu şekildedir:
version: "2.0"

services:
  llm-inference:
    image: vllm/vllm-openai:latest
    args:
      - --model
      - deepseek-ai/DeepSeek-R1-Distill-Qwen-14B
      - --tensor-parallel-size
      - "1"
      - --max-model-len
      - "4096"
      - --gpu-memory-utilization
      - "0.90"
    expose:
      - port: 8000
        as: 8000
        to:
          - global: true

profiles:
  compute:
    llm-inference:
      resources:
        cpu:
          units: 8
        memory:
          size: 32Gi
        storage:
          - size: 60Gi
        gpu:
          units: 1
          attributes:
            vendor:
              nvidia:
                - model: a10g
  placement:
    dtag:
      pricing:
        llm-inference:
          denom: uakt
          max_price: 50
SDL Parametrelerinin Teknik Analizi:
--tensor-parallel-size "1": Model tek bir GPU kartına sığacağı için paralel işleme katsayısını 1 olarak belirliyoruz. Eğer 70B veya daha büyük bir model ayağa kaldıracak olsaydık bu değeri artırıp GPU unit sayısını değiştirmemiz gerekirdi.--gpu-memory-utilization "0.90": vLLM motorunun vRAM’in %90’ını KV Cache işlemleri için rezerve etmesini sağlayarak isteklerin işlenme hızını maksimuma çıkarıyoruz.attributes (nvidia -> model: a10g): Fiyat/performans oranı en yüksek olan ve 24GB vRAM sunan Nvidia A10G donanımını spesifik olarak talep ediyoruz.
3. Node.js Backend Entegrasyonu (Saf Kod Yaklaşımı)
Konteyneriniz dezantralize ağdaki doğrulayıcılar tarafından onaylanıp aktif hale geldikten sonra sistem size genel erişime açık, şifreli bir uç nokta (endpoint URL) sağlayacaktır. Bu aşamada SaaS projenizin backend katmanına giderek harici ağır SDK yükleri eklemeden, doğrudan yerel fetch API’si ile yapay zeka çıkarım motorunuza bağlanabilirsiniz.
Aşağıdaki Node.js/TypeScript kodu, dezantralize kümenizdeki vLLM sunucusuna güvenli bir şekilde istek atar, hata yakalama mekanizmasını yönetir ve gelen yanıtı temiz bir şekilde döndürür:
import fetch from 'node-fetch';

interface AIChatResponse {
    choices: Array<{ message: { content: string; }; }>;
}

async function getInferenceResult(userPrompt: string): Promise<string> {
    // Dezantralize ağın sağladığı canlı vLLM endpoint adresi
    const clusterEndpoint = "https://akash.network";

    const requestPayload = {
        model: "deepseek-ai/DeepSeek-R1-Distill-Qwen-14B",
        messages: [
            {
                role: "system",
                content: "Sen bulut maliyetlerini optimize eden yardımcı bir yazılım geliştirme asistanısın."
            },
            {
                role: "user",
                content: userPrompt
            }
        ],
        temperature: 0.5,
        max_tokens: 2048,
        stream: false
    };

    try {
        const apiResponse = await fetch(clusterEndpoint, {
            method: 'POST',
            headers: {
                'Content-Type': 'application/json',
                'Authorization': 'Bearer altyapi-ag-toke-korumasi' // Opsiyonel güvenlik katmanı
            },
            body: JSON.stringify(requestPayload)
        });

        if (!apiResponse.ok) {
            const errorDetails = await apiResponse.text();
            throw new Error(`Küme yanıt vermedi HTTP ${apiResponse.status}: ${errorDetails}`);
        }

        const data = (await apiResponse.json()) as AIChatResponse;

        if (!data.choices || data.choices.length === 0) {
            throw new Error("Yapay zeka motorundan boş veya geçersiz veri döndü.");
        }

        return data.choices[0].message.content;

    } catch (processError) {
        // Hata loglama ve yedek (fallback) mekanizması
        console.error("[Inference Failover Log]:", processError);

        // Üretim ortamında buraya yedek olarak OpenAI veya Anthropic API entegrasyonu yazılabilir.
        // Böylece dezantralize sağlayıcıda anlık kopma olsa dahi SaaS uygulamanız çökmez.
        throw new Error("Sistem şu anda isteğinizi işleyemiyor, teknik ekip bilgilendirildi.");
    }
}
4. Sürdürülebilirlik ve Failover (Yedeklilik) Stratejisi
Dezantralize altyapıların en büyük handikapı, sunucu sağlayıcısının elektrik kesintisi veya ağ kopması gibi durumlarda merkezi AWS kadar katı bir SLA (Service Level Agreement) taahhütü sunamamasıdır. Bu yüzden profesyonel bir SaaS ürünü yönetiyorsanız, yukarıdaki kod bloğunda yer alan catch mekanizmasının içerisine bir Failover (Yedeklilik) Havuzu eklemelisiniz.
İdeal senaryoda istemci isteği önce dezantralize GPU ağındaki sunucunuza gider. Eğer sunucudan 500 ms veya 1 saniye içinde yanıt alınamazsa ya da bağlantı hatası düşerse, kod otomatik olarak yedek plandaki ticari bir API sağlayıcısına (örneğin OpenRouter veya Groq API) yönlenir. Bu mimari sayesinde, isteklerin %95’ini neredeyse sıfıra yakın maliyetle dezantralize ağınızda eritirken, %5’lik olası kesinti diliminde kullanıcılarınıza hiçbir kesinti hissettirmemiş olursunuz.
5. Brüt Kar Marjı (Gross Margin) Hesaplaması
Klasik token mimarisinde ayda 10 milyon istek alan bir SaaS projesi ortalama girdi/çıktı yoğunluğuna göre aylık 3.000(ila 7.000) arasında API faturası öder. Dezantralize ağda kiralayacağınız tek bir Nvidia A10G sunucusunun aylık sabit maliyeti ise ihale durumuna göre ortalama 120(ila 180) arasındadır. vLLM’in eşzamanlı istek işleme (batched inference) yeteneği sayesinde tek bir kart aynı anda onlarca kullanıcıyı rahatlıkla besleyebilir. Bu da uygulamanızın operasyonel ölçeklenme maliyetini neredeyse sıfıra indirir.