
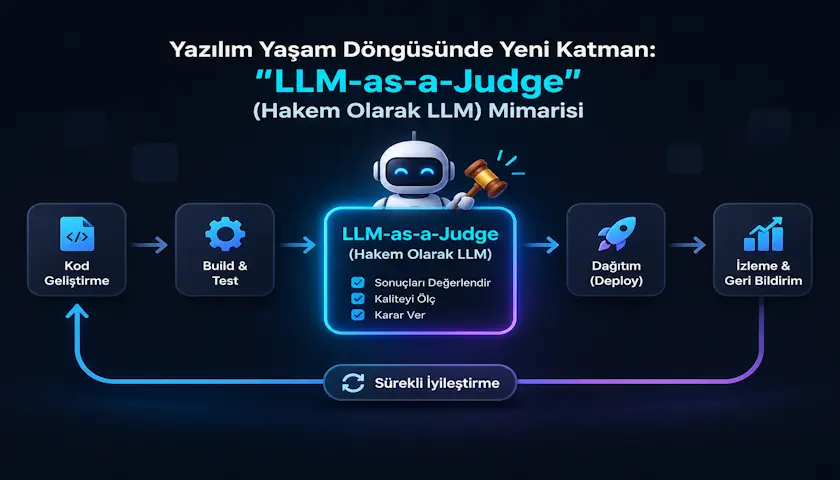
Yazılım geliştirme süreçleri, Cursor, Claude 3.5 Sonnet ve GitHub Copilot gibi araçların hayatımıza girmesiyle radikal bir hız kazandı. Ancak bu hız, beraberinde büyük bir krizi de getirdi: Yapay zeka kod borcu (AI-Generated Code Debt). Yapay zekaya saniyeler içinde binlerce satır kod yazdırabiliyoruz; fakat bu kodların iş mantığına uygunluğunu, güvenlik standartlarını ve doğruluğunu denetlemek yine insan mühendislerin saatlerini alıyor. İşte tam bu noktada, yazılım yaşam döngüsünün (SDLC) yeni ve en kritik katmanı devreye giriyor: LLM-as-a-Judge (Hakem Olarak LLM) Mimarisi.
LLM-as-a-Judge, bir yapay zeka modelinin ürettiği çıktıları veya yazdığı kodları, önceden tanımlanmış katı kurallar ve test senaryoları çerçevesinde denetlemesi için ikinci bir uzman yapay zeka modelinin (hakem) konumlandırılmasıdır. Bu mimari, manuel QA (Kalite Güvence) ve kod inceleme (code review) süreçlerini tamamen otonom hale getirmeyi hedefler.
LLM-as-a-Judge Nasıl Çalışır?
Klasik yazılım testlerinde girdiler ve çıktılar deterministiktir. Örneğin; topla(2,3) fonksiyonunun 5 döndürmesini beklersiniz. Ancak bir yapay zeka ajanına "Bana KVKK uyumlu bir kullanıcı kayıt fonksiyonu yaz" dediğinizde, gelen kod her seferinde farklı bir semantik yapıda olacaktır. Geleneksel test araçları bu esnekliği denetleyemez.
LLM-as-a-Judge mimarisinde süreç üç aşamalı bir boru hattı (pipeline) şeklinde işler:
- Üretim Aşaması (Generator): Geliştirici veya otonom yazılım ajanı, hedef göreve göre kodu üretir.
- Kriter ve Bağlam Enjeksiyonu (Evaluation Rubric): Hakem modele, kodun uyması gereken katı mimari kurallar ve performans kriterleri birer prompt süzgeci olarak verilir.
- Yargılama ve Puanlama (The Judge): Hakem model, üretilen kodu ve kriterleri girdi olarak alır; kodu satır satır inceleyerek JSON formatında bir "Geçti/Kaldı" raporu üretir.
Hakem Seçimi: Hangi Modeli Yargıç Yapmalıyız?
Her yapay zeka modeli hakemlik koltuğuna oturamaz. Üretici model olarak daha hızlı ve ucuz modeller tercih edilebilirken, hakem modelin muhakeme (reasoning) yeteneğinin, üretici modelden çok daha yüksek olması şarttır. Bir hatayı tespit etmek, o hatayı yapmamaktan daha derin bir mimari algı gerektirir.
Bugün endüstride hakem olarak konumlandırılan modeller genellikle akıl yürütme yeteneği gelişmiş olan OpenAI o1, Claude 3.5 Sonnet veya derin düşünme mimarisine sahip DeepSeek R1'dir. Projenizin bütçesine, hız gereksinimine ve zeka kapasitesine göre doğru hakem modelini seçmek için AI Karşılaştırma analizlerinden yararlanarak en yüksek muhakeme skoruna sahip güncel modelleri belirlemeniz gerekir.
Güvenlik Denetimi ve Siber Risklerin Önlenmesi
Yapay zekanın yazdığı kodlar sadece mantıksal hatalar barındırmaz; aynı zamanda SQL Injection, XSS veya hatalı yetkilendirme gibi ciddi siber güvenlik açıklarını da beraberinde getirebilir. Hakem LLM katmanı, statik kod analiz araçlarının kaçırdığı mantıksal güvenlik açıklarını yakalamakta harikadır.
Hakem modele yüklenen süzgeç, üretilen fonksiyonu siber güvenlik perspektifinden denetler. Örneğin, hakeme verilen prompt şu şekildedir:
"Sana verilen kod bloğunu OWASP Top 10 açıklarına göre incele. Eğer veri tabanı sorgularında parametreleştirme kullanılmadıysa veya kullanıcı girdisi temizlenmeden işleme alındıysa görevi 'FAIL' olarak işaretle."
Bu otonom süzgeç, sisteminizin canlıya çıkmadan önce kendi kendini denetleyen bir siber kalkanla korunmasını sağlar.
import os
import json
from openai import OpenAI

# OpenAI istemcisini başlatıyoruz (Hakem olarak güçlü bir model seçilmelidir)
client = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))

# 1. ÜRETİCİ (GENERATOR) KATMANININ ÜRETTİĞİ KOD (Riskli bir kod örneği)
generated_code = """
def get_user_data(username):
    # RİSK: SQL Injection açığı barındıran güvensiz kod
    query = f"SELECT * FROM users WHERE username = '{username}'"
    return db.execute(query)
"""

# 2. KRİTER VE BAĞLAM ENJEKSİYONU (Evaluation Rubric)
judge_prompt = """
Sen kıdemli bir Siber Güvenlik Hakemisin (Judge).
Sana verilen kod bloğunu OWASP Top 10 açıklarına (özellikle SQL Injection) göre incele.
Eğer kodda parametreleştirme kullanılmadıysa veya girdi temizlenmediyse görevi 'FAIL' olarak işaretle.

Yanıtını SADECE aşağıdaki JSON formatında ver, başka hiçbir metin ekleme:
{
  "status": "PASS" veya "FAIL",
  "reason": "Kısa ve net gerekçe"
}
"""

# 3. YARGILAMA VE PUANLAMA (The Judge)
response = client.chat.completions.create(
    model="gpt-4o",
    response_format={ "type": "json_object" },
    messages=[
        {"role": "system", "content": judge_prompt},
        {"role": "user", "content": f"Denetlenecek Kod:n{generated_code}"}
    ]
)

# Hakem modelin verdiği otonom karar
judge_result = json.loads(response.choices.message.content)
print(json.dumps(judge_result, indent=2, ensure_ascii=False))
{
"status": "FAIL",
"reason": "SQL sorgusunda f-string kullanılarak doğrudan parametre birleştirme yapılmış. Bu durum SQL Injection riskine yol açar. Parametrik sorgu (Parameterized Query) kullanılmalıdır."
}Geliştirdiğiniz bu ajanların veya hakem modellerin dışarıdan gelebilecek manipülasyonlara karşı ne kadar dirençli olduğunu ölçmek için sisteminizi entegrasyon öncesinde kapsamlı bir AI Güvenlik Testi süzgecine sokarak prompt sızıntısı ve jailbreak risklerini de minimize etmelisiniz.
Büyük Bir Problem: Token Maliyeti ve Optimizasyon
LLM-as-a-Judge mimarisinin en büyük handikapı finansal maliyettir. Hakem modele her seferinde "Sistem Kuralları + Kodun Tamamı + Test Senaryoları" gönderildiğinde, girdi (input) token sayıları devasa boyutlara ulaşır. Hele ki hakem olarak pahalı modeller kullanıyorsanız, her kod inceleme işlemi şirketin API faturasını kabartır.
Bu maliyet krizini aşmak için prompt sıkıştırma (prompt compression) ve semantik şablonlar kullanılması zorunludur. Hakem modele gönderilen sistem yönergelerindeki gereksiz kelimeleri temizlemek, kod bloklarını optimize etmek ve kuralları semantik olarak yoğunlaştırmak için bir Prompt Sıkıştırıcı algoritmasından faydalanmak, LLM-as-a-Judge boru hattının sürdürülebilir ve maliyet-etkin kalmasını sağlayan en kritik adımdır.
Otonom QA Katmanına Geçiş
Yazılım dünyası, insanların kod yazıp yine insanların test ettiği dönemden, yapay zekanın kod yazıp başka bir yapay zekanın denetlediği proaktif bir döneme evriliyor. LLM-as-a-Judge mimarisi, yazılım ekiplerinin hızından ödün vermeden kod kalitesini en üst seviyede tutabilmesinin tek yoludur. Eğer projenizde AI ajanları kullanıyorsanız, kod kalitenizi şansa bırakmamak adına kendi hakem katmanınızı inşa etmeye hemen başlamalısınız.