
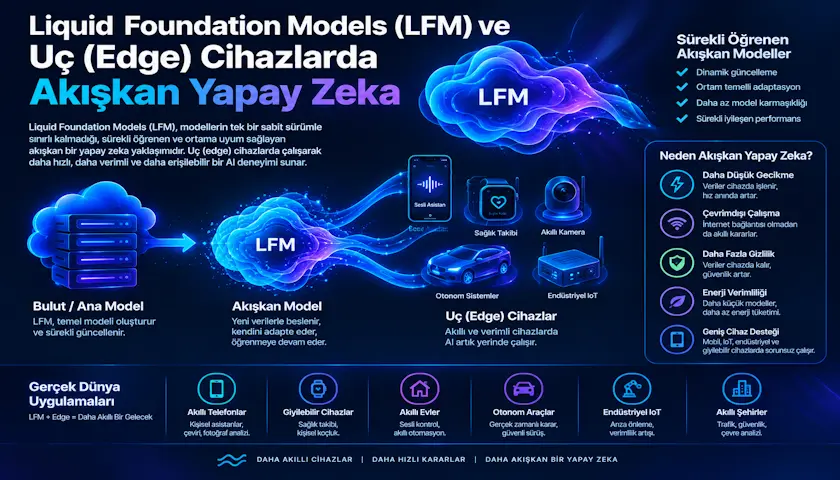
Akıllı telefonlarda, giyilebilir teknolojilerde ve uç (edge) donanımlarda yerel yapay zeka (On-Device AI) çalıştırma çabaları, bugüne kadar hep çok katı donanım engellerine takıldı. Geleneksel üretken yapay zeka modelleri (Llama 3.2 veya Gemini Nano serileri gibi), mimari olarak sabit ağırlıklı Transformer yapılarına dayanır. Bu modellerin en büyük yapısal defosu, girdi uzadıkça (context penceresi büyüdükçe) işlemci yükünün ve RAM tüketiminin karesel (quadratic – $O(N^2)$) olarak artmasıdır. Mobil cihazların sınırlı batarya ve termal bütçeleri düşünüldüğünde, bu karesel artış tam bir operasyonel çıkmazdır.
MIT laboratuvarlarında (CSAIL) temelleri atılan ve [Liquid AI](https://www.liquid.ai/ “Liquid AI”) tarafından ticari seviyeye taşınan Liquid Foundation Models (LFM – Sıvı Temel Modelleri), bu tıkanıklığı birinci prensiplerden (first principles) yola çıkarak çözüyor. Zaman serisi verilerini durağan matrisler yerine sürekli akan bir diferansiyel denklem sistemi gibi işleyen sıvı sinir ağları, yapay zekaya çalışma zamanında (runtime) akışkanlık kazandırır. Bu rehberde, mobil ekosistemde LFM mimarisinin getirdiği yapısal avantajları, alt donanım katmanındaki bellek optimizasyonlarını ve PyTorch üzerinde mobil uyumlu, üretime hazır bir sıvı hücrenin (Liquid Cell) nasıl kurgulanacağını derinlemesine inceliyoruz.
1. Liquid Sinir Ağlarının (LNN) Matematiksel Temeli: ODE ve CfC Mimarisi
Klasik yapay zeka modelleri discrete-time (kesikli zaman) adımlarıyla çalışır. Yani Layer 1 tetiklenir, ardından sırasıyla diğer katmanlar ateşlenir; zaman yapay olarak bölünmüştür. Oysa gerçek dünya verileri (ses, video, sensör akışları, borsa tikleri) kesintisiz bir süreklilik arz eder. Sıvı sinir ağları, gücünü Sıradan Diferansiyel Denklemlerden (ODE – Ordinary Differential Equations) alır. Modelin içindeki nöronların durum değişimi şu diferansiyel formülle yönetilir:
dx(t) / dt = -x(t) / tau + f(x(t), I(t), t)Burada x(t) nöronun iç durumunu, I(t) dışarıdan gelen anlık girdiyi, tau ise modelin kendi kendine dinamik olarak değiştirebildiği zaman sabitini (time-constant) temsil eder. Ancak ilk nesil LNN modellerinde bu diferansiyel denklemleri çözmek için kullanılan nümerik çözücüler (ODE Solvers) çok ciddi bir hesaplama yavaşlığına yol açıyordu.
MIT araştırmacıları, bu problemi ortadan kaldırmak için CfC (Closed-Form Continuous-Time) yani Kapalı Form Sürekli Zamanlı ağ mimarisini geliştirdiler. CfC, diferansiyel denklemi çalışma zamanında çözmek yerine, denklemin integral çözümünü içeren analitik bir yaklaşım kullanır. Böylece sıvı modeller, Transformer veya Mamba mimarileriyle aynı hesaplama hızına ($O(N)$ karmaşıklığına) erişirken, sürekli zamanın getirdiği esneklik ve adaptasyon yeteneğini de tamamen korumayı başardı.
2. Mimari Karşılaştırma: Neden Edge AI İçin Biçilmiş Kaftan?
Projenizde neden geleneksel bir Transformer yerine LFM mimarisi seçmeniz gerektiğini anlamak için donanım seviyesindeki farklara göz atmak gerekir. Aşağıdaki yapısal analiz, modellerin edge ortamındaki davranışlarını özetlemektedir:
- Transformers (Örn: Llama serisi): Karesel karmaşıklığa sahiptir ($O(N^2)$). Bağlam büyüdükçe bellek tüketimi (KV Cache) doğrusal olmayan şekilde şişer. Çalışma zamanında statiktir, girdinin gürültüsüne göre esneyemez. En az 24GB+ üst düzey GPU donanımlarına ihtiyaç duyar.
- State Space Models (Örn: Mamba): Doğrusal karmaşıklığa sahiptir ($O(N)$). Gizli durumu (hidden state) sabittir. Ancak verinin zaman aralıkları (delta t) değiştiğinde veya düzensiz zaman serilerinde veriyi manipüle etmek (padding/imputation) gerekir. Orta seviye 24GB altı GPU’larda koşturulabilir.
- Liquid Neural Networks (LFM): Doğrusal karmaşıklığa sahiptir ($O(N)$). CfC ve SSM hibrit yapısını kullanır. Bellek tüketimi tamamen sabittir. Çalışma zamanında (inference) verinin gürültüsüne göre denklemlerini anlık modifiye edebilir. Düzensiz gelen zaman serilerini ve gürültülü sensör verilerini native olarak destekler. 8GB RAM’e sahip Jetson Orin modüllerinde veya mobil NPU’larda (Apple Silicon / Snapdragon Elite) çok rahat çalışır.
3. PyTorch ile Üretime Hazır (Production-Ready) Sıvı Hücre Tasarımı
Bir mobil veya IoT projesine gömülmek üzere tasarlanmış, ileri düzey bir Sıvı Hücre katmanının PyTorch implementasyonu aşağıdadır. Bu kod bloğu, Euler entegrasyon mantığını CfC yaklaşımıyla birleştirerek modelin girdi hızına göre iç yapısını nasıl esnettiğini saf kod seviyesinde ortaya koyar:
import torch
import torch.nn as nn
import math

class AdvancedLiquidCell(nn.Module):
    def __init__(self, input_dim: int, hidden_dim: int):
        super(AdvancedLiquidCell, self).__init__()
        self.hidden_dim = hidden_dim

        # Girdi ve saklı durumu işleyen doğrusal projeksiyonlar
        self.input_gate = nn.Linear(input_dim, hidden_dim)
        self.hidden_gate = nn.Linear(hidden_dim, hidden_dim)

        # Nöronun "akışkanlık" seviyesini belirleyen doğrusal olmayan sistem fonksiyonu
        self.sys_non_linear = nn.Linear(input_dim + hidden_dim, hidden_dim)

        # Dinamik Zaman Sabiti (Tau) - Her nöron grubu için öğrenilebilir parametre
        self.tau_initializer = nn.Parameter(torch.Tensor(1, hidden_dim))
        self.reset_parameters()

    def reset_parameters(self):
        # Parametrelerin kararlı başlaması için Xavier/Glorot başlatma kurgusu
        nn.init.kaiming_uniform_(self.input_gate.weight, a=math.sqrt(5))
        nn.init.kaiming_uniform_(self.hidden_gate.weight, a=math.sqrt(5))
        # Tau parametresini 0.1 ile 1.0 arasında kararlı bir gecikme için başlatıyoruz
        nn.init.constant_(self.tau_initializer, 0.5)

    def forward(self, x: torch.Tensor, h_prev: torch.Tensor, delta_t: float = 1.0) -> torch.Tensor:
        """
        x: [Batch_Size, Input_Dim] -> Sensör akışı, ses spektrumu veya token vektörü
        h_prev: [Batch_Size, Hidden_Dim] -> Bir önceki zaman adımından kalan akışkan iç durum
        delta_t: İki veri girdisi arasında geçen gerçek zaman farkı (Sıvı ağların kalbi)
        """
        # Girdi ve saklı durumların kapı mekanizması üzerinden eşlenmesi
        x_proj = self.input_gate(x)
        h_proj = self.hidden_gate(h_prev)

        # Hücreye giren tüm bilginin birleştirilmesi
        combined_features = torch.cat([x, h_prev], dim=-1)

        # Sistemin anlık değişim türevi (Derivative vector)
        system_activity = torch.tanh(self.sys_non_linear(combined_features))

        # Tau parametresini pozitif tutmak için softplus fonksiyonundan geçiriyoruz
        # Bu, sistemin patlamasını (gradient explosion) engeller.
        soft_tau = torch.softplus(self.tau_initializer)

        # Analitik sürekli zaman entegrasyon adımı (CfC yaklaşımı)
        # Gelen verinin gecikme süresi (delta_t) formüle doğrudan etki eder
        integration_factor = torch.exp(-delta_t * (soft_tau + x_proj))

        # Yeni saklı durum (Hidden State) hesaplanıyor
        h_new = h_prev * integration_factor + (1.0 - integration_factor) * system_activity

        return h_new

# --- Üretim Ortamı Simülasyonu ---
if __name__ == "__main__":
    # Örnek: Mobil cihazda koşan bir model (3 eksenli İvmeölçer + 3 eksenli Jiroskop = 6 Boyutlu girdi)
    batch_size = 1
    sensor_features = 6
    hidden_units = 64

    # Hücreyi örnekleme
    liquid_node = AdvancedLiquidCell(input_dim=sensor_features, hidden_dim=hidden_units)

    # Başlangıç saklı durumu (Bellekte sıfır maliyetle başlar)
    current_hidden_state = torch.zeros(batch_size, hidden_units)

    print("--- Mobil Cihaz Sensör Akışı Başladı ---")
    # Zamana yayılmış 3 farklı düzensiz veri paketi simülasyonu
    for step, time_gap in enumerate([0.1, 0.4, 1.2]): # delta_t süreleri sürekli değişiyor
        raw_sensor_packet = torch.randn(batch_size, sensor_features)

        # İleri besleme tetikleniyor
        current_hidden_state = liquid_node(raw_sensor_packet, current_hidden_state, delta_t=time_gap)

        print(f"Adım {step+1} (Zaman Aralığı: {time_gap}s) -> Bellek Durum Matrisi: {current_hidden_state.shape}")
4. Mobil Platformlarda Model Sıkıştırma ve Entegrasyon Pipeline’ı
Eğittiğiniz bir LFM mimarisini akıllı telefonların içerisine (NPU/CPU katmanına) indirmek için izlemeniz gereken endüstriyel standarttaki boru hattı (pipeline) şu aşamalardan oluşur:
- ONNX Export Kurgusu: Yazılan PyTorch modeli
torch.onnx.exportfonksiyonu ile platform bağımsız hale getirilir. Sıvı modeller kontrol akışları (if-else) yerine diferansiyel denklemler içerdiğinden, ONNX grafiğine tam uyumlu olarak serileştirilir. - Post-Training Quantization (PTQ): Modelin FP32 (32-bit Floating Point) ağırlıkları, INT8 (8-bit Integer) seviyesine indirilir. Bu işlem model boyutunu 4 kat küçültürken, mobil cihazın NPU (Neural Processing Unit) çekirdeklerini tam kapasiteyle tetiklemesini sağlar.
- ONNX Export Kurgusu: Yazılan PyTorch modeli